KI-Crawler, robots.txt und llms.txt für WordPress-Shops: Welche Bots Sie zulassen sollten (2026)
Welche KI-Bots Sie in einem WordPress- oder WooCommerce-Shop zulassen und welche Sie blockieren sollten: die Bots, die Zitierungen bringen (OAI-SearchBot, ChatGPT-User, PerplexityBot, Claude-SearchBot, Claude-User, Googlebot, Bingbot), im Vergleich zu den reinen Trainings-Bots (GPTBot, ClaudeBot, Google-Extended, CCBot), die robots.txt-Regeln, das verifizierte Besuchsprotokoll und wofür llms.txt tatsächlich da ist.
Ein WordPress-Shop sollte die KI-Bots zulassen, die Zitierungen bringen (Such-Bots und Assistenten auf Abruf wie OAI-SearchBot, ChatGPT-User, PerplexityBot, Claude-SearchBot, Claude-User, Googlebot, Bingbot, Applebot), und kann die reinen Trainings-Bots (GPTBot, ClaudeBot, Google-Extended, Applebot-Extended, CCBot, Bytespider und andere) ohne Verlust an Sichtbarkeit blockieren. Eine Antwortmaschine, die eine Seite nicht lesen kann, kann sie auch nicht zitieren; „alle KI-Bots blockieren“ schaltet die Sichtbarkeit in der KI-Suche also ab. llms.txt ist eine Markdown-Übersicht der Website für Sprachmodelle: harmlos, günstig und nichts, wovon eine große Antwortmaschine gesagt hätte, dass sie es liest.
Dieser Leitfaden verwendet einen Demo-Shop auf WooCommerce (Northbean Coffee Supply) mit dem CiteProof-Plugin. Das Plugin schreibt die Regeln und die Datei; die Überlegungen sind dieselben, wenn Sie robots.txt von Hand bearbeiten.
Warum ein blockierter Bot keine Zitierung bedeutet
Jeder Bot, ob Suchmaschine oder KI, liest vor allem anderen eine Datei: robots.txt. Die meisten WordPress-Shops befinden sich in einem von zwei Zuständen. Entweder enthält die Datei keine Regel für KI-Bots, sodass diese alles lesen können, oder ein Plugin oder eine Voreinstellung des Hosters hat eine Regel ergänzt, die jeden KI-Crawler blockiert, und niemand erinnert sich daran.
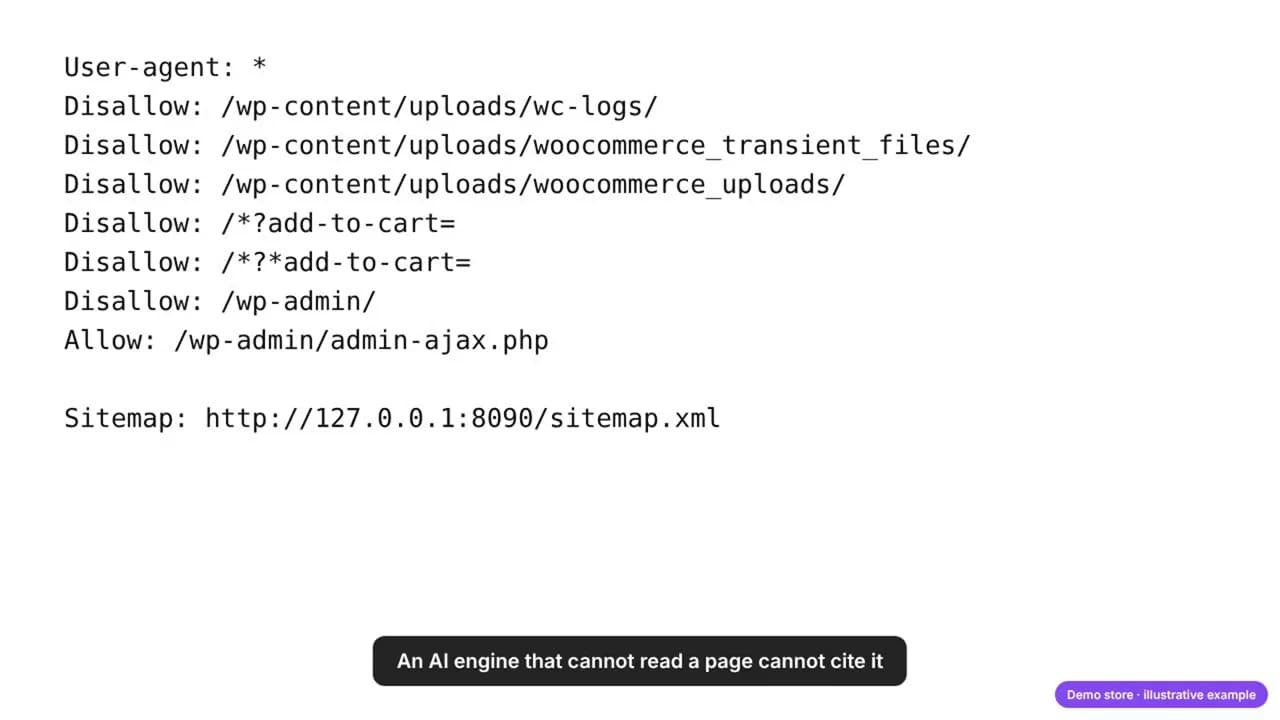
Die Wirkung ist mechanisch. Wenn jemand ChatGPT, Perplexity oder Claude eine Frage stellt, ruft die Antwortmaschine vor der Antwort eine Handvoll Seiten ab und nennt sie als Quellen. Eine Seite, die sie nicht abrufen kann, kann keine Quelle sein, ganz gleich, was Sie sonst daran verbessert haben: Schema, Beschreibungen, Richtlinien. Der Crawler-Zugang ist die erste Prüfung bei der Answer Engine Optimization (AEO), der Optimierung für Antwortmaschinen, noch vor jeder Arbeit am Inhalt.
Die zwei Arten von KI-Bots
Der Fehler besteht darin, alle KI-Bots als eine Sache zu behandeln. Es gibt zwei Gruppen, mit unterschiedlichem Zweck und unterschiedlichen Folgen.
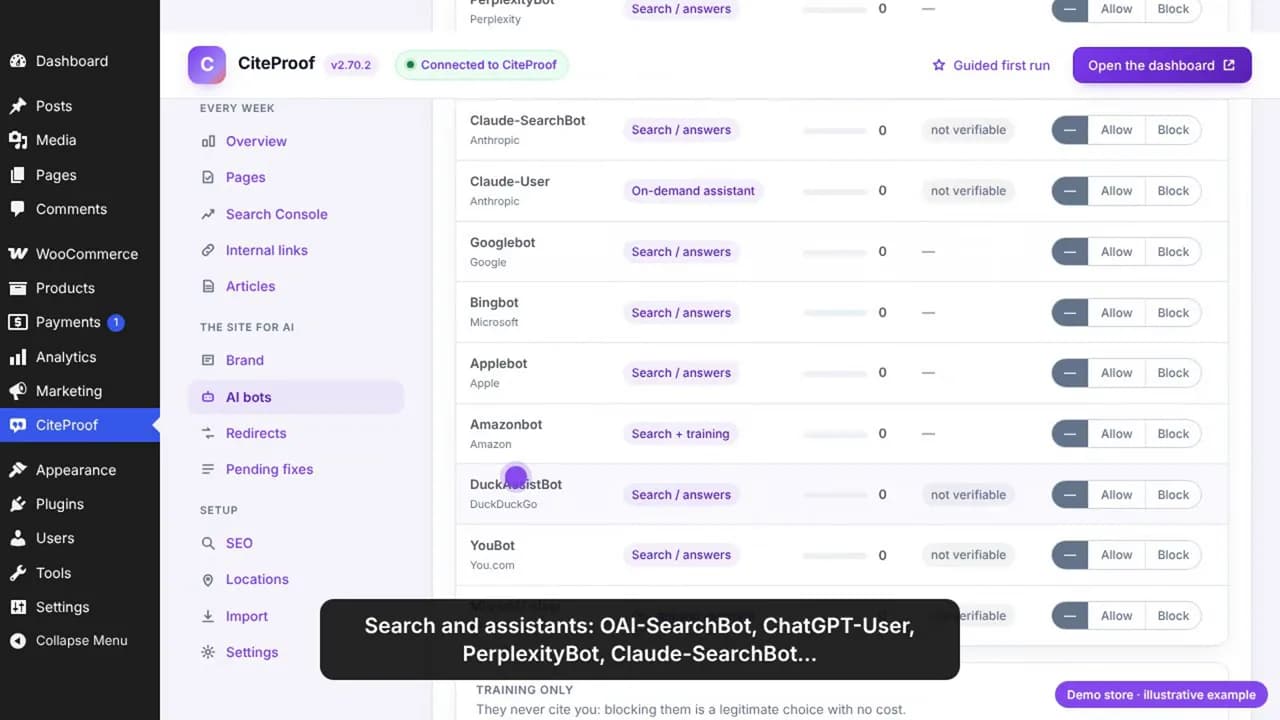
Bots, die Zitierungen bringen. Such-Bots und Assistenten auf Abruf: Sie rufen Seiten ab, um eine Frage zu beantworten, und zwar jetzt, und die Antwort verlinkt auf das, was sie abgerufen haben. Die Zwecke unten stammen aus der Dokumentation des jeweiligen Betreibers: OpenAI [1], Anthropic [2] und Google [3].
| Bot | Betreiber | Zweck |
|---|---|---|
| OAI-SearchBot | OpenAI | Suche / Antworten |
| ChatGPT-User | OpenAI | Assistent auf Abruf |
| PerplexityBot | Perplexity | Suche / Antworten |
| Perplexity-User | Perplexity | Assistent auf Abruf |
| Claude-SearchBot | Anthropic | Suche / Antworten |
| Claude-User | Anthropic | Assistent auf Abruf |
| Googlebot | Suche / Antworten (und KI-Übersichten) | |
| Bingbot | Microsoft | Suche / Antworten (und Copilot) |
| Applebot | Apple | Suche / Antworten |
| Amazonbot | Amazon | Suche und Training |
| DuckAssistBot | DuckDuckGo | Suche / Antworten |
| YouBot | You.com | Suche / Antworten |
| MistralAI-User | Mistral | Assistent auf Abruf |
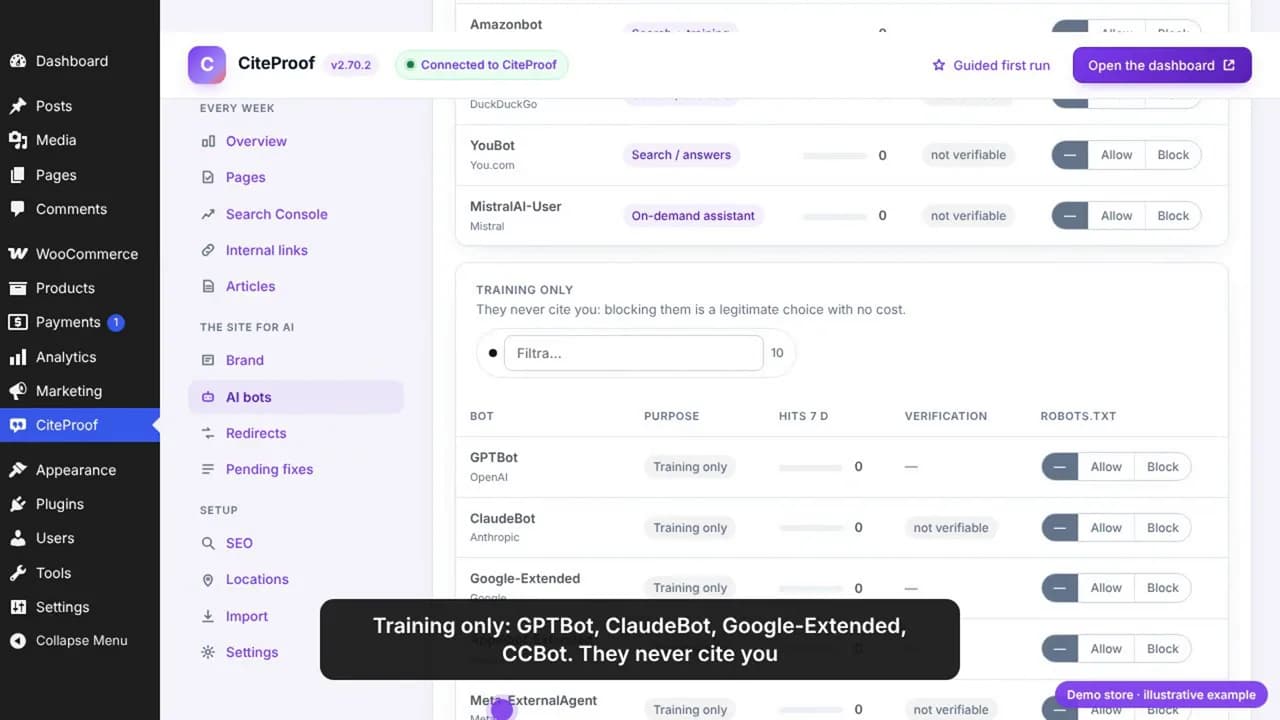
Reine Trainings-Bots. Sie sammeln Texte, um Modelle zu trainieren. Sie zitieren Sie nie, und sie zu blockieren ändert nichts daran, ob eine Antwort Ihren Shop nennt.
| Bot | Betreiber | Zweck |
|---|---|---|
| GPTBot | OpenAI | Nur Training |
| ClaudeBot | Anthropic | Nur Training |
| Google-Extended | Training und Grounding von Gemini; beeinflusst weder die Aufnahme noch das Ranking in der Google-Suche | |
| Applebot-Extended | Apple | Nur Training |
| Meta-ExternalAgent, FacebookBot | Meta | Nur Training |
| Bytespider | ByteDance | Nur Training |
| CCBot | Common Crawl | Nur Training |
| Diffbot | Diffbot | Nur Training |
| cohere-ai | Cohere | Nur Training |
Wer die erste Gruppe blockiert, schaltet die Sichtbarkeit in der KI-Suche ab. Die zweite zu blockieren ist eine legitime Entscheidung ohne Kosten für die Sichtbarkeit: eine Frage der Richtlinie, nicht der Suchmaschinenoptimierung.
Die Voreinstellung: Suche ja, Training nein
Sie müssen nicht Bot für Bot entscheiden. Im Plugin öffnet unter KI-Bots eine einzige Voreinstellung, „Empfohlen: Suche ja, Training nein“, die erste Gruppe und schließt die zweite. Die Tabelle füllt sich, und das Feld rechts zeigt genau, was in robots.txt geschrieben wird. Nichts ändert sich, bis Sie auf Regeln speichern klicken. Google, Bing und Apple bleiben immer zugelassen, denn eine Sperre würde den Shop aus der Suche entfernen.
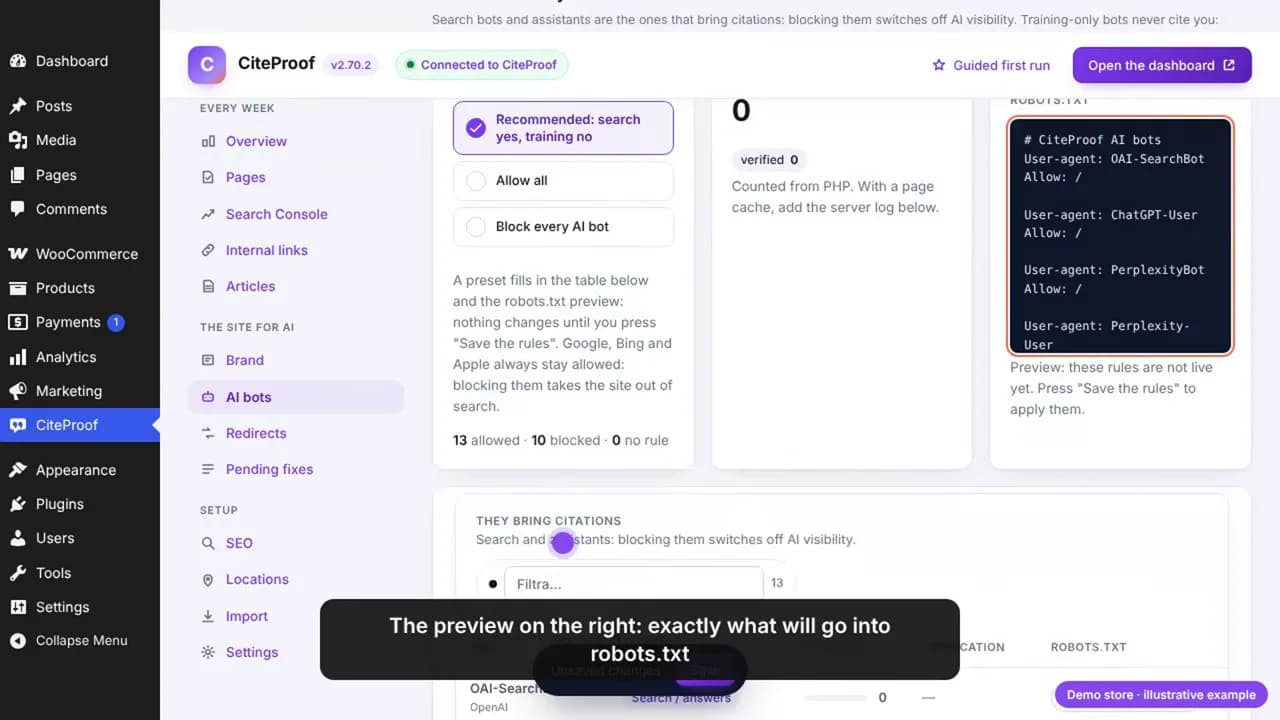
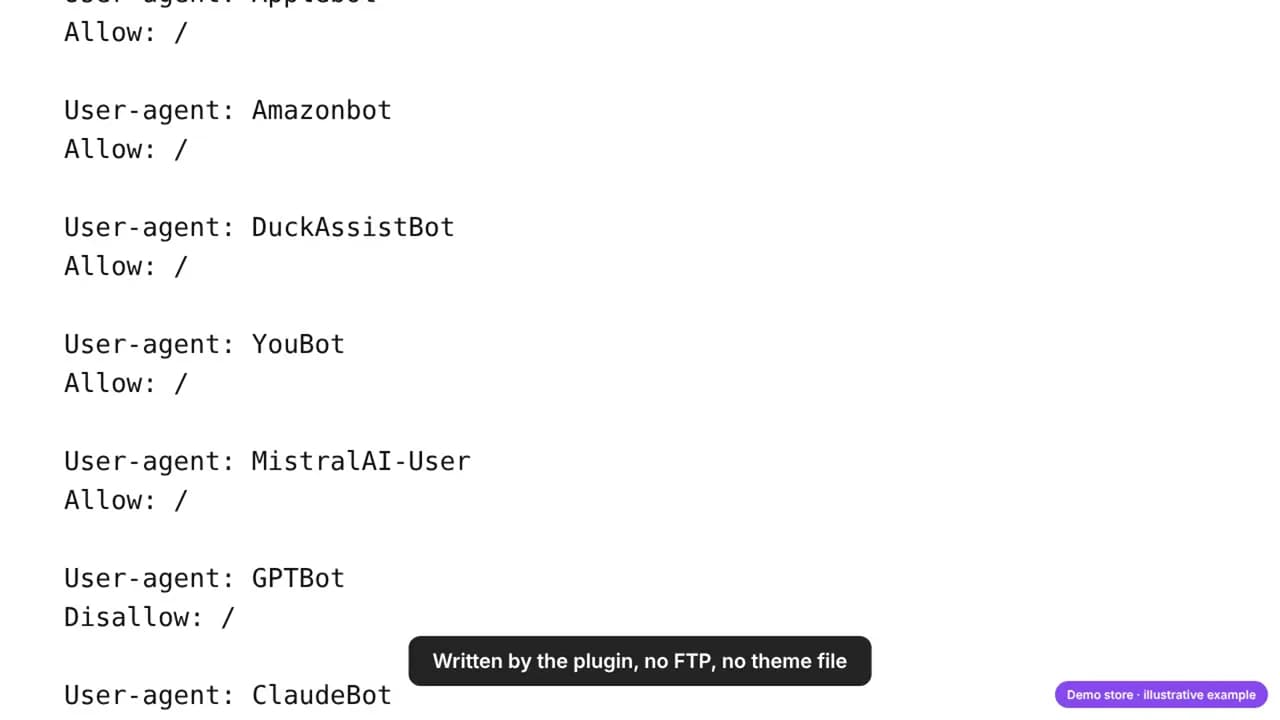
Die Regeln, die das Plugin schreibt, sehen in robots.txt-Syntax für die wichtigsten Bots so aus: die Bots, die Zitierungen bringen, zugelassen, die reinen Trainings-Bots blockiert, danach die Sitemap (das Plugin schreibt einen Block für jeden Bot aus beiden Tabellen; ersetzen Sie die Sitemap-Adresse durch Ihre eigene):
User-agent: OAI-SearchBot
Allow: /

User-agent: ChatGPT-User
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: Claude-User
Allow: /

User-agent: Googlebot
Allow: /

User-agent: Bingbot
Allow: /

User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: Google-Extended
Disallow: /

Sitemap: https://yourstore.com/wp-sitemap.xml
Die Such- und Assistenten-Bots erhalten ein ausdrückliches Allow, sodass die Erlaubnis jede pauschale Regel übersteht, die ein anderes Plugin ergänzen könnte; die reinen Trainings-Bots erhalten Disallow; die Sitemap-Zeile bleibt für alle stehen. Das Plugin liefert das bei jeder Anfrage aus, es gibt also keine Datei hochzuladen und nichts zu bearbeiten, wenn ein neuer Bot auftaucht: Die Liste wird mit dem Plugin aktualisiert. Wenn Sie robots.txt von Hand bearbeiten, gelten dieselben Regeln; beachten Sie dabei, dass ein Disallow: / unter User-agent: * alle blockiert, auch Googlebot.
Prüfen Sie, was Sie bereits haben. Eine Plugin-Einstellung „KI blockieren“ oder eine Hosting-Vorlage, die OAI-SearchBot oder PerplexityBot neben GPTBot aufführt, ist genau die Einstellung, die Zitierungen kostet. Der kostenlose Scan liest Ihre aktuelle robots.txt und nennt die Bots, die sie blockiert.
Wer den Shop tatsächlich liest: Verifizierung und Protokoll
Eine Regel ist nur die halbe Sache. Das Plugin zeichnet jeden Besuch eines KI-Bots auf: welcher Bot, welche Seite, wann. Bei den Bots, deren Betreiber ihre Adressbereiche veröffentlichen, wird der Besuch mit diesen Bereichen abgeglichen, sodass ein Scraper, der sich als Googlebot ausgibt, nicht zählt. Bots, deren Bereiche nicht veröffentlicht sind, werden als „nicht verifizierbar“ markiert.
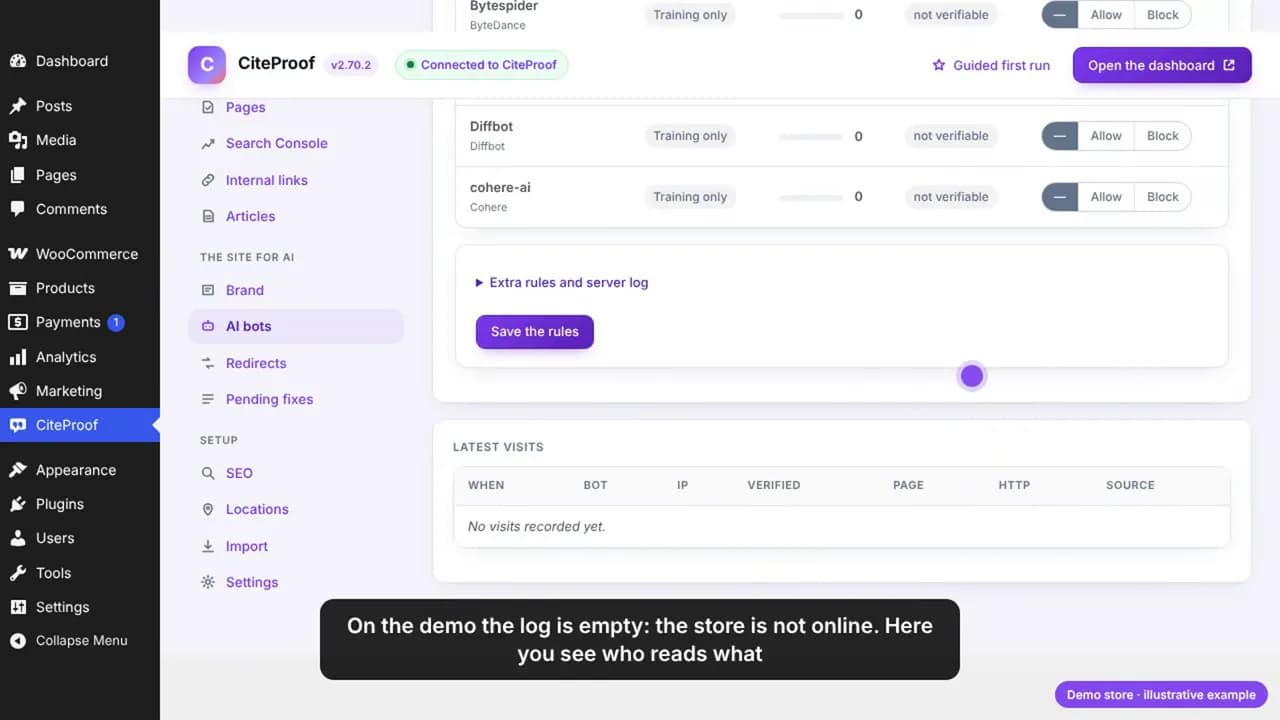
In einem Live-Shop erfahren Sie aus diesem Protokoll, welche Seiten die Antwortmaschinen diese Woche tatsächlich gelesen haben und welche wichtigen Seiten sie nie berührt haben. Mit einem Seiten-Cache vor WordPress sieht der PHP-Zähler weniger Besuche: Fügen Sie das Server-Protokoll hinzu, dann liest das Plugin die Besuche von dort.
Was llms.txt ist und was nicht
llms.txt ist eine Markdown-Datei im Stammverzeichnis der Website, eine kurze Übersicht für Sprachmodelle: der Name des Shops als Überschrift, eine einzeilige Zusammenfassung, dann Listen mit Links zu den wichtigsten Seiten, den neuesten Artikeln und den Produktkategorien [4]. Format, Herkunft und wer die Datei liest, behandelt der Artikel Was ist llms.txt. Das Plugin erzeugt sie aus den Inhalten der Website und aktualisiert sie täglich, sodass sie nie veraltet, und liefert sie virtuell aus: keine Datei auf der Festplatte, also funktioniert es auch bei Hostern mit schreibgeschütztem Dateisystem. Für eine Website ohne das Plugin durchsucht der kostenlose llms.txt-Generator die Website und baut die Datei aus ihren echten URLs, bereit zum Hochladen ins Stammverzeichnis.
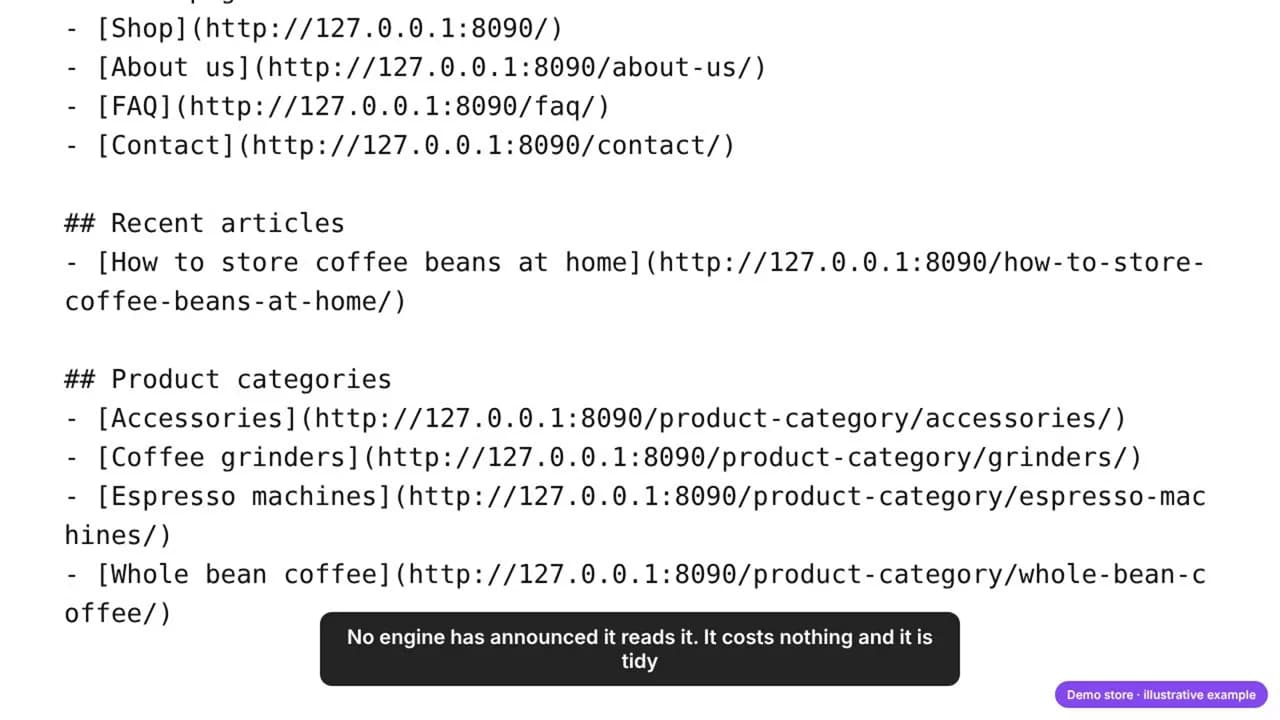
Seien Sie genau, was ihren Wert angeht. Keine große KI-Antwortmaschine hat gesagt, dass sie diese Datei liest, und Google erklärt, dass die Google-Suche, einschließlich ihrer KI-Funktionen, sie nicht verwendet [5]. Sie verbessert also keinen Score und ersetzt nicht die Inhalte auf den Seiten. Sie kostet nichts, manche Kunden und Tools prüfen, ob sie vorhanden ist, und eine aufgeräumte Datei schadet nicht. Was eine Seite tatsächlich auffindbar macht, ist ein Link darauf von einer Seite, die bereits gelesen wird.
Die „Übersicht“ des Plugins gleicht das Besuchsprotokoll mit Ihren Inhalten ab und listet die wichtigen Seiten auf, die noch keine KI gelesen hat. Drei Maßnahmen, in der Reihenfolge ihrer Bedeutung: Verlinken Sie sie von den Seiten, die gelesen werden; übermitteln Sie sie an IndexNow, das Protokoll, mit dem Bing und andere neue Adressen erfassen; setzen Sie sie in llms.txt ganz nach oben.
Wo das alles zu finden ist
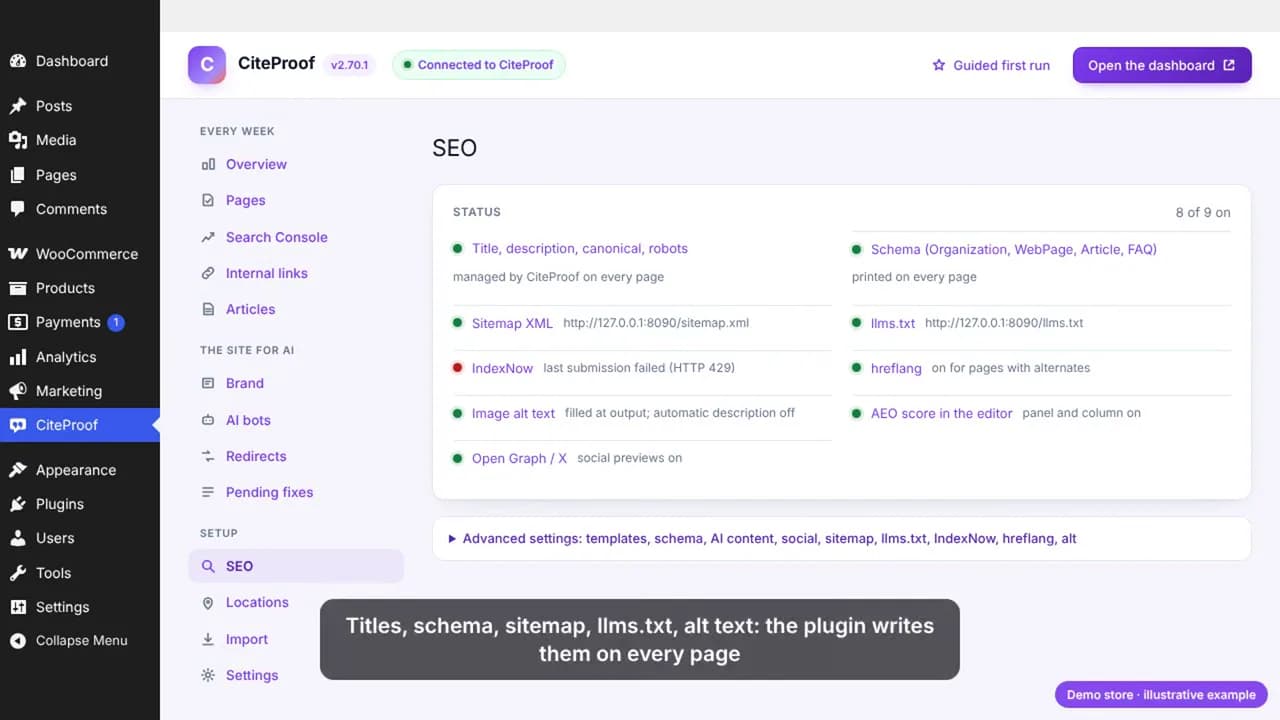
Alles in diesem Leitfaden ist im Plugin ein einziger Bildschirm: Der SEO-Status zeigt robots-Regeln, Sitemap, llms.txt, IndexNow und das Schema, jeweils ein- oder ausgeschaltet, jeweils mit Link. Nichts wird ins Theme geschrieben, und nichts erfordert FTP. Prüfen Sie diesen Bildschirm und das Bot-Protokoll einmal im Monat; mehr Wartung ist nicht nötig.
Welche KI-Bots blockiert Ihr Shop heute?
Der kostenlose Scan von CiteProof liest Ihre robots.txt und Ihre Seiten so, wie die Antwortmaschinen es tun, und sagt Ihnen, welche Bots Sie zuerst freigeben sollten.
Häufig gestellte Fragen
Sollte ich GPTBot in meinem WordPress-Shop blockieren?
Das können Sie, ohne Kosten für die Sichtbarkeit in der KI-Suche: OpenAI dokumentiert GPTBot als Crawler für Trainingsdaten, und wenn Sie ihn per Disallow ausschließen, teilen Sie OpenAI mit, Ihre Inhalte nicht für das Training zu verwenden [1]. Zugelassen bleiben müssen OAI-SearchBot und ChatGPT-User, die Bots, mit denen ChatGPT Seiten abruft, wenn es eine Frage beantwortet und seine Quellen nennt.
Verschwinde ich aus den Google KI-Übersichten, wenn ich Google-Extended blockiere?
Nein. Google-Extended steuert, ob Ihre Inhalte für das Training und Grounding von Gemini-Modellen verwendet werden; Google erklärt, dass es weder die Aufnahme noch das Ranking einer Website in der Google-Suche beeinflusst [3], und die KI-Übersichten sind Teil der Suche. Wer Googlebot blockiert, würde dagegen aus allen verschwinden.
Was ist llms.txt und brauche ich eine?
Eine Markdown-Datei im Stammverzeichnis, die die wichtigsten Seiten der Website für Sprachmodelle auflistet. Anders als robots.txt erlaubt oder blockiert sie nichts. Keine große Antwortmaschine hat gesagt, dass sie sie liest, sie ist also optional; sie kostet nichts, und das Plugin erzeugt sie aus Ihren Inhalten. Über Zitierungen entscheiden der Crawler-Zugang und die Inhalte der Seiten, nicht diese Datei.
Wie erstelle ich eine llms.txt ohne das Plugin?
Verwenden Sie den kostenlosen llms.txt-Generator: Er durchsucht die Website, baut die Datei aus ihren echten URLs, und Sie laden sie ins Stammverzeichnis hoch, sodass sie unter yourdomain.com/llms.txt erreichbar ist. Prüfen Sie die Liste vor der Veröffentlichung und halten Sie sie kurz: die Seiten, die ein Assistent als Erstes lesen soll.
Woran erkenne ich, ob ein KI-Bot meine Website wirklich besucht hat?
Vergleichen Sie die Adresse des Besuchers mit den Bereichen, die der Betreiber des Bots veröffentlicht. Das Plugin macht das für die Bots, die solche Bereiche veröffentlichen, und markiert jeden Besuch als verifiziert; Bots ohne veröffentlichte Bereiche werden als nicht verifizierbar angezeigt. Ein User-Agent-String allein lässt sich fälschen.
Ich verwende ein Cache-Plugin. Funktioniert das Besuchsprotokoll trotzdem?
Teilweise: Seiten, die aus dem Cache ausgeliefert werden, führen kein PHP aus, deshalb entgehen sie dem Zähler. Fügen Sie im Plugin das Zugriffsprotokoll des Webservers hinzu (Abschnitt „Zusätzliche Regeln und Server-Protokoll“), dann werden die Besuche von dort gelesen.
Gilt das auch für Shopify?
Die Überlegungen sind dieselben, aber Shopify verwaltet robots.txt über die robots-Vorlage des Themes, und die CiteProof-App prüft den Crawler-Zugang im Rahmen des Shop-Checks. Dieser Leitfaden behandelt WordPress und WooCommerce, wo das Plugin die Regeln schreibt.
Quellen
- [1] Overview of OpenAI Crawlers · OpenAI · 2026 · abgerufen am 2026-10-14
- [2] Does Anthropic crawl data from the web, and how can site owners block the crawler? · Anthropic · 2026 · abgerufen am 2026-10-14
- [3] Google's common crawlers · Google for Developers · 2026 · abgerufen am 2026-10-14
- [4] The /llms.txt file · Jeremy Howard, llmstxt.org · September 2024 · abgerufen am 2026-10-14
- [5] Google's Guide to Optimizing for Generative AI Features on Google Search · Google Search Central · 2026 · abgerufen am 2026-10-14
Weiterlesen
CiteProof verfolgt die Sichtbarkeit Ihrer Marke in KI-Antwortmaschinen und sagt Ihnen, was Sie ändern müssen, um zitiert zu werden. Mit einer Regel: Der Score steigt erst, wenn der Verify Bot bestätigt, dass die Korrektur wirklich live ist.